Probabilità e statistica
Probabilità, distribuzioni, campioni, test, correlazione e gli errori statistici più comuni.
Campionamento: metodi, dimensione del campione e distorsioni
Campionamento casuale, sistematico, stratificato e a grappoli: quanto deve essere grande il campione e come notare selezione, non risposta e copertura.
Confronti multipli e p-hacking: troppi test, falsi risultati
Perché con 20 test un falso positivo è probabile al 64%, come agiscono le correzioni di Bonferroni, Holm e Benjamini-Hochberg e come evitare il p-hacking.
Correlazione non è causalità: confondenti, inversioni e selezione
Le cinque spiegazioni alternative di una correlazione, dai confondenti alla causalità inversa alla selezione, e come avvicinarsi a una prova causale.
Correlazione di Pearson e Spearman: leggerla senza errori
Cosa misura il coefficiente di correlazione, Pearson e Spearman a confronto, il quartetto di Anscombe e le trappole di outlier e relazioni non lineari.
La distribuzione binomiale: contare i successi in n prove
Quando si usa la binomiale, come si calcola P(X = k) con il coefficiente binomiale, media e varianza, e un esempio di controllo qualità con Python.
La distribuzione normale e la regola 68-95-99,7
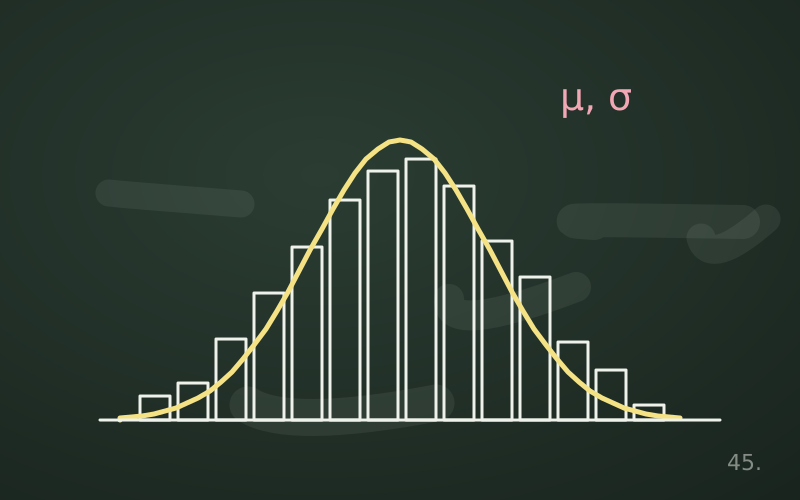
La curva a campana spiegata in pratica: punteggi z, regola 68-95-99,7, calcolo delle code con Python e i casi in cui assumere la normalità è un errore.
La distribuzione di Poisson: contare eventi nel tempo
Quando usare la Poisson per ticket, errori e richieste, come calcolare le probabilità, fissare soglie d'allarme e vedere la sovradispersione.
Errori di primo e secondo tipo e potenza statistica
Falsi positivi e falsi negativi nei test, cosa sono α, β e potenza, e come calcolare in anticipo il campione di un test A/B con un esempio numerico.
Cos'è la probabilità: tre interpretazioni e gli assiomi
Probabilità classica, frequentista e soggettiva a confronto, con gli assiomi di Kolmogorov e le regole che ne derivano spiegate con esempi su dadi e carte.
Intervalli di confidenza: come si calcolano e cosa significano
Intervalli di confidenza per medie e proporzioni con esempi numerici, la lettura corretta del 95%, il metodo bootstrap e gli errori di lettura più comuni.
Legge dei grandi numeri e fallacia del giocatore
Cosa garantisce davvero la legge dei grandi numeri, perché il caso non «compensa» le serie negative e come i campioni piccoli producono risultati estremi.
Media, mediana e moda: quale indice usare e quando
Media aritmetica, mediana, moda, media troncata, geometrica e armonica: come si calcolano, come reagiscono agli estremi e quale scegliere caso per caso.
Misure di dispersione: deviazione standard, IQR e valori anomali
Campo di variazione, varianza, deviazione standard con n − 1, scarto interquartile, MAD e coefficiente di variazione per misurare la variabilità.
Il paradosso del compleanno e le collisioni negli identificativi
Bastano 23 persone per superare il 50% di probabilità di un compleanno in comune. Il calcolo, la formula approssimata e cosa insegna su hash e ID casuali.
Il paradosso di Simpson: quando i dati aggregati si invertono
Un gruppo migliore in ogni sottogruppo può risultare peggiore nel totale: il paradosso di Simpson con un esempio numerico, le cause e quale dato usare.
Probabilità condizionata e indipendenza spiegate con esempi
Come si calcola la probabilità condizionata, cosa significa davvero indipendenza tra eventi e perché confondere P(A|B) con P(B|A) porta a errori seri.
Il problema di Monty Hall: perché conviene cambiare porta
Il problema di Monty Hall spiegato con tre ragionamenti e una simulazione in Python: cambiare porta vince 2 volte su 3, ed ecco da dove nasce l'errore.
Regressione lineare semplice: minimi quadrati e residui
Come si calcola una retta di regressione con i minimi quadrati, cosa indicano pendenza, intercetta e R², come leggere i residui e perché non estrapolare.
Regressione verso la media: perché gli estremi non si ripetono
Perché dopo un risultato estremo il successivo tende a essere più normale, come inganna nel valutare interventi e come aiuta il gruppo di controllo.
Simulazione Monte Carlo in Python: stimare con il caso
Come usare la simulazione Monte Carlo per stimare π e la durata di un progetto con NumPy, quanto è precisa la stima e quali errori tipici evitare.
Teorema di Bayes e falsi positivi: il caso del test diagnostico
Il teorema di Bayes applicato a un test con il 99% di sensibilità: perché un positivo può essere sbagliato in 5 casi su 6 e come aggiornare la stima.
Il teorema del limite centrale spiegato con una simulazione
Perché le medie campionarie tendono a una normale anche con dati asimmetrici, cos'è l'errore standard, quando 30 casi non bastano e una prova in Python.
Il test del chi quadrato: adattamento e indipendenza
Il test del chi quadrato per verificare un dado o confrontare tassi di errore tra gruppi, con calcoli passo per passo, gradi di libertà e condizioni d'uso.
Test di ipotesi e p-value: cosa dicono e cosa non dicono
Ipotesi nulla, livello di significatività e p-value spiegati con una moneta sospetta, le interpretazioni sbagliate da evitare e il ruolo dell'effetto.
Variabili aleatorie, valore atteso e varianza senza misteri
Cos'è una variabile aleatoria, come si calcolano valore atteso e varianza, la linearità dell'attesa e perché la media non basta a valutare un rischio.