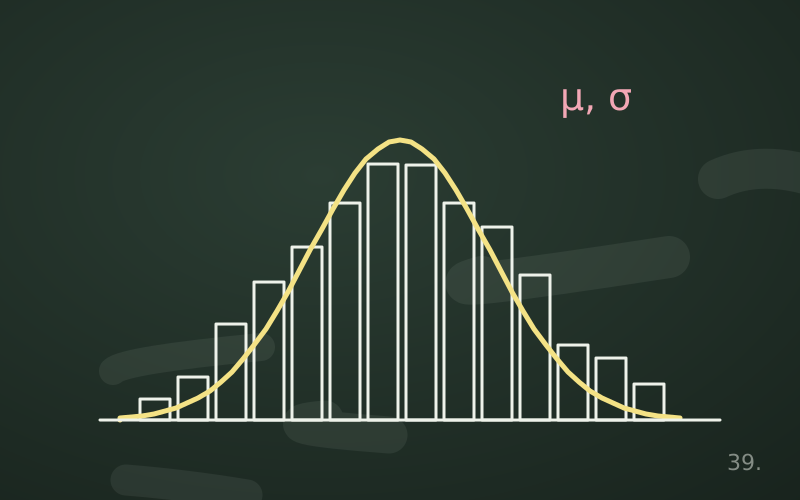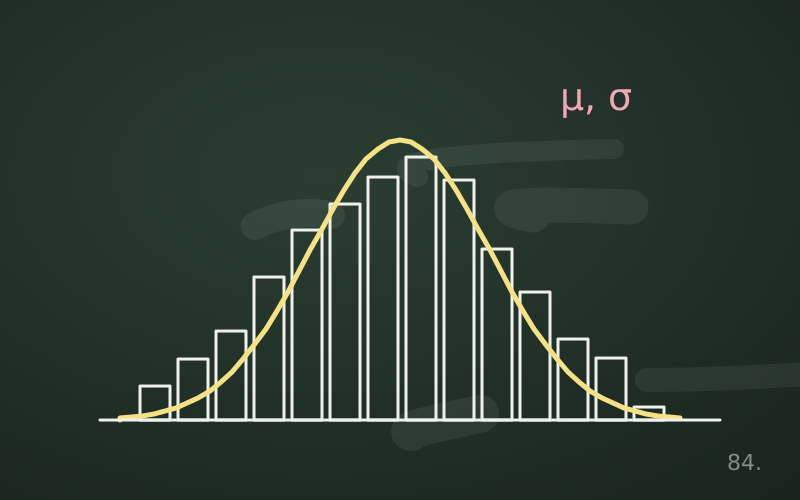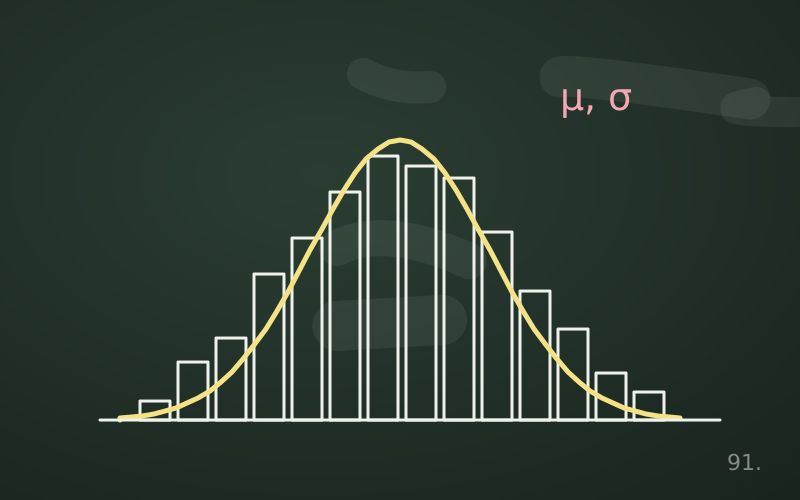
Il teorema del limite centrale è il motivo per cui gran parte della statistica classica funziona. Dice una cosa sorprendente: anche se i singoli dati hanno una distribuzione strana, asimmetrica o a gradini, la media di un campione abbastanza grande ha una distribuzione approssimativamente normale. È ciò che permette di costruire intervalli di confidenza e test senza conoscere la forma esatta dei dati.
L'enunciato in parole semplici
Prendiamo n osservazioni indipendenti da una stessa distribuzione con media μ e deviazione standard σ finita. Calcoliamo la loro media. Se ripetessimo l'operazione moltissime volte, le medie ottenute avrebbero una distribuzione che:
- è centrata su μ, la media vera;
- ha deviazione standard σ / √n, detta errore standard;
- diventa sempre più simile a una normale al crescere di n.
L'ultimo punto è il cuore del teorema, e vale qualunque sia la forma della distribuzione di partenza, purché la varianza sia finita.
Un esempio con i dadi
Il risultato di un dado ha una distribuzione piatta: ogni valore da 1 a 6 ha probabilità 1/6, nessuna campana. Ma la media di due dadi ha già una forma triangolare, con 3,5 come valore più probabile. La media di cinque dadi assomiglia a una campana, e quella di trenta dadi è quasi indistinguibile da una normale. La media resta sempre 3,5, mentre la dispersione si stringe: la deviazione standard di un singolo dado è circa 1,71, quella della media di 30 dadi circa 1,71/√30 ≈ 0,31.
Una simulazione con dati asimmetrici
L'esempio più istruttivo usa dati molto asimmetrici, come i tempi di risposta di un servizio. Simuliamoli con una distribuzione esponenziale di media 200 millisecondi:
import numpy as np

rng = np.random.default_rng(1)
dati = rng.exponential(200, size=(10_000, 40))  # 10.000 campioni da 40
medie = dati.mean(axis=1)

print(medie.mean())        # circa 200
print(medie.std())         # circa 200 / sqrt(40), cioè circa 31,6
print(np.percentile(medie, [2.5, 97.5]))
I singoli tempi sono fortemente asimmetrici: molti valori bassi e una lunga coda verso destra. Le medie di 40 tempi, invece, si distribuiscono in modo quasi simmetrico intorno a 200, con una dispersione di circa 31,6. Un istogramma delle medie mostra una campana riconoscibile, con una leggera asimmetria residua.
L'errore standard e il costo della precisione
La formula σ / √n ha una conseguenza pratica importante: la precisione della media cresce con la radice quadrata del numero di osservazioni. Per dimezzare l'errore standard non basta raddoppiare il campione, bisogna quadruplicarlo. Passare da 100 a 400 misure dimezza l'incertezza; per dimezzarla ancora servono 1.600 misure.
È il motivo per cui oltre una certa soglia raccogliere altri dati rende sempre meno, e per cui conviene decidere in anticipo quale precisione è davvero necessaria.
Perché è così importante
Grazie al teorema possiamo dire, con una buona approssimazione, che la media campionaria cade entro circa due errori standard dalla media vera in circa il 95% dei campioni. Da qui nascono:
- gli intervalli di confidenza per una media o una proporzione;
- i test sulle medie, come il test t e il test z;
- le carte di controllo che sorvegliano la media di un processo produttivo;
- i margini di errore dei sondaggi.
Tutti questi strumenti funzionano anche se i dati originali non sono normali, proprio perché lavorano sulle medie.
Quando il teorema non basta
La regola dei 30 casi non è universale
Si legge spesso che con 30 osservazioni la normalità è garantita. È una regola empirica, non un teorema. Con dati poco asimmetrici bastano anche meno casi; con dati molto asimmetrici o con code pesanti ne servono molti di più. Proporzioni molto vicine a 0 o a 1, come un tasso di conversione dello 0,5%, richiedono campioni ampi perché la distribuzione della proporzione diventi simmetrica.
Varianza infinita
Il teorema richiede una varianza finita. Esistono distribuzioni, come la distribuzione di Cauchy, per cui la media di molti valori non si stabilizza affatto: la media di mille osservazioni è dispersa quanto una singola osservazione. Nei dati reali con code estremamente pesanti, per esempio alcune distribuzioni di importi o di dimensioni, le medie convergono molto lentamente e un singolo valore può spostarle di molto.
Dati non indipendenti
Se le osservazioni sono correlate tra loro, come misure consecutive nel tempo o utenti dello stesso gruppo, l'errore standard reale è più grande di σ / √n. Usare la formula classica porta a intervalli troppo stretti e a falsa sicurezza.
Riguarda le medie, non i singoli dati
Il teorema non dice che i dati diventano normali con un campione grande. I tempi di risposta restano asimmetrici anche con un milione di misure; è la loro media a comportarsi bene. Per stimare il 99° percentile della latenza il teorema del limite centrale non aiuta.
In sintesi
- La media di molte osservazioni indipendenti tende a una distribuzione normale.
- L'errore standard della media vale σ / √n: per dimezzarlo serve un campione quattro volte più grande.
- Su questo risultato si basano intervalli di confidenza, test e margini di errore.
- Dati molto asimmetrici, varianza infinita o osservazioni dipendenti ne limitano l'uso.
- Il teorema riguarda le medie, non la distribuzione dei singoli dati.